7 сентября 2026, 18:20
После нескольких десятков материалов я начал замечать одну и ту же проблему. Факты в статье правильные, команды проверены, схема работает — а текст всё равно выглядит так, будто его собирали по шаблону.
Сначала идёт аккуратное вступление. Потом пять одинаковых разделов. Каждый раздел объясняет сам себя, а в конце появляется вывод, который ещё раз пересказывает всё написанное. Ошибок вроде нет. Читать скучно.
Поэтому в рабочий контур HomeLab я добавил Sepia — открытый skill для редактирования структуры AI-текста.
Не ещё один список запрещённых слов
Большинство «humanizer»-инструкций устроены просто: убрать несколько модных слов, сократить тире, добавить разговорных оборотов и немного испортить пунктуацию. Получается тот же машинный текст, только специально помятый.
Sepia начинает глубже. Для художественного текста она проверяет архитектуру сюжета, причинно-следственные связи, способы передачи эмоций и слишком удобные развязки. Для рабочих материалов правила другие: релиз-нотами, ответами в PR, постмортемами, тикетами и техническими статьями нельзя управлять одной универсальной памяткой.
В техническом профиле есть требования, которые мне подходят:
- начинать с реальной проблемы, а не с определения технологии;
- показывать хотя бы один неудачный путь;
- не раздавать всем вариантам одинаковое количество текста;
- указывать условия рядом с числами;
- не придумывать команды, версии и результаты;
- заканчивать рекомендацией, а не обязательным «итогом и планами».
Это не обещание обмануть детектор. Задача практичнее: оставить в статье информацию, позицию автора и неровность настоящей работы.
Четыре режима вместо одной кнопки
В установленной версии Sepia есть четыре основные операции.
| Режим | Что делает |
|---|---|
write |
Строит новый материал сразу по правилам выбранного жанра |
review |
Показывает дефекты, но ничего не переписывает |
refactor |
Точечно исправляет существующий текст, сохраняя структуру и голос |
recreate |
Извлекает факты и пишет материал заново, когда локальные правки уже не спасают |
Есть общий маршрутизатор $sepia и отдельные входы для каждой операции. Для новых статей HomeLab будет использоваться технический профиль; опубликованные материалы массово переписывать я не собираюсь. Старый текст — часть истории проекта, а автоматическая «чистка всего» слишком легко меняет смысл.
Установка тоже дала полезный пример
README предлагает нативную установку плагина в Codex через marketplace:
codex plugin marketplace add Nanako0129/sepia
codex plugin add sepia@sepia
Первый шаг у меня прошёл. Второй — нет: текущий Codex CLI добавил marketplace, но не увидел пакет sepia в его индексе.
Можно было объявить установку успешной после первой зелёной строки. Именно так и рождаются плохие технические статьи: автор описывает ожидаемый сценарий, а не то, что произошло.
Я проверил содержимое репозитория, убедился, что skill состоит из Markdown-правил и не запускает сторонние команды, затем установил полный комплект штатным skill-installer. В локальном каталоге появились:
sepia
sepia-write
sepia-review
sepia-refactor
sepia-recreate
sepia-hemingway
После установки каталоги были сверены с исходным репозиторием. Версия канонического skill на момент проверки — 0.8.0.
Пример на нашем материале
Возьмём типичный абзац, который формально сообщает правильную информацию:
В рамках данного этапа была реализована комплексная интеграция
дополнительных навыков Hermes Agent. Это позволило повысить
эффективность работы, улучшить управление контекстом и обеспечить
более стабильное выполнение инфраструктурных задач.
Он ничего не врёт, но его можно поставить почти в любую статью про AI. Нет события, цены решения и точки, где автору пришлось остановиться.
В реальной истории было иначе:
После установки Skill Retrieval Telegram-бот замолчал ещё до вызова
модели. Я отключил plugin, повторил короткий запрос — ответ вернулся.
Оптимизацию оставили выключенной: экономия контекста не нужна, если
агент перестаёт отвечать.
Вторая версия короче и полезнее. В ней есть проверяемая последовательность, неудача и решение, с которым можно поспорить. Мы не добавляли эмоции и не заменяли слова синонимами — просто вернули в текст то, что действительно случилось.
Как это будет работать в HomeLab
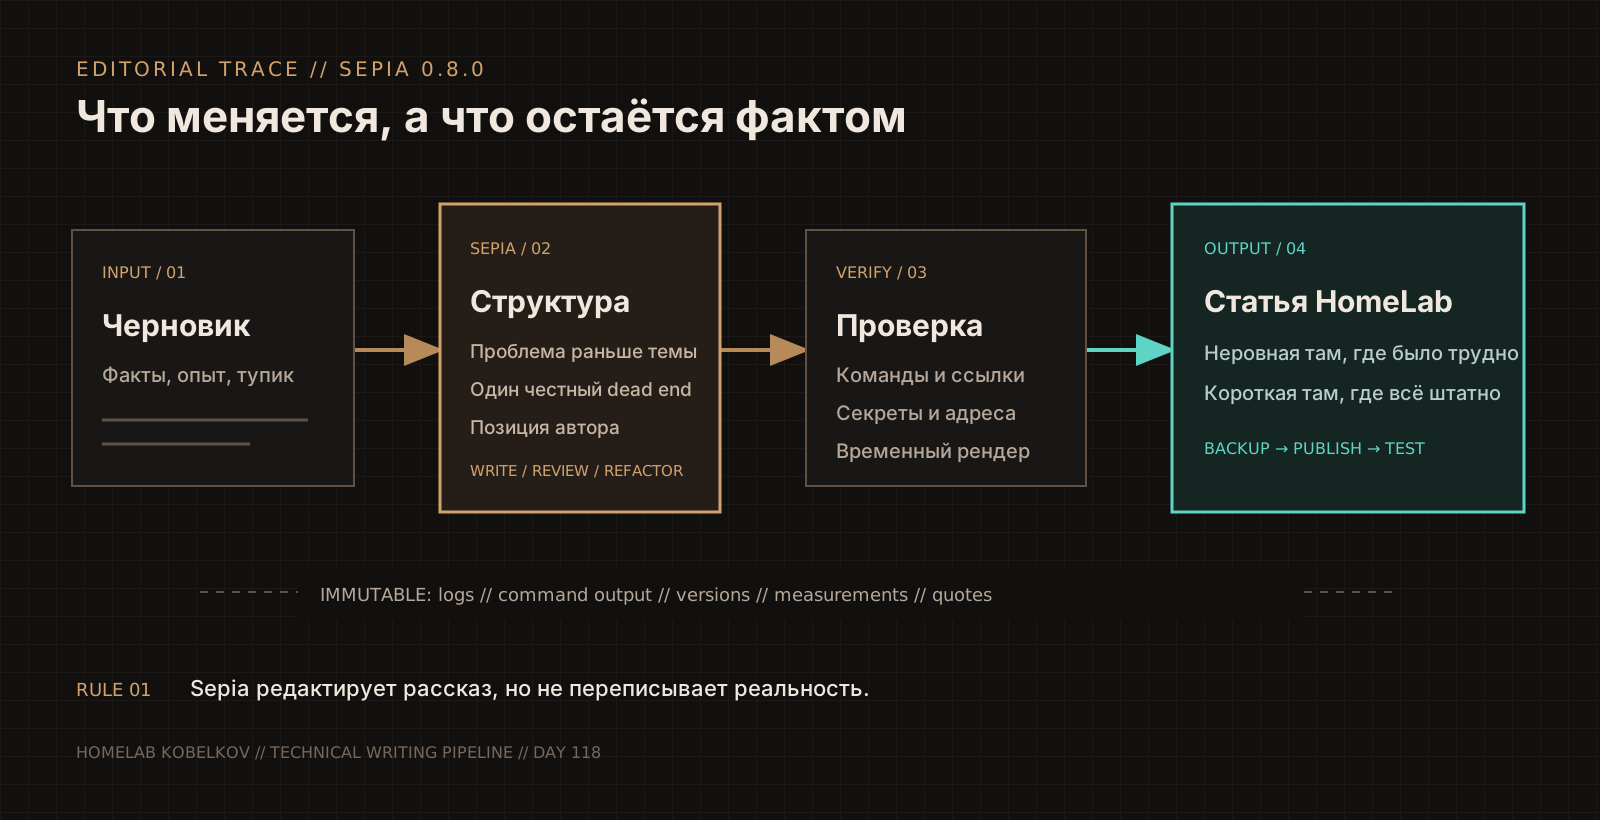
Новый процесс для статьи теперь выглядит так:
факты и журналы
       |
       v
черновик в моём стиле
       |
       v
Sepia: структура -> плотность -> ритм
       |
       v
проверка команд, ссылок и секретов
       |
       v
рендер во временный HTML
       |
       v
backup -> publish.sh -> smoke-test
Sepia отвечает только за редактуру. Она не подтверждает версию пакета, не проверяет команду на сервере и не решает, можно ли публиковать IP-адрес. Эти проверки остаются отдельными этапами.
Для HomeLab это принципиальная граница. Красивый абзац с неверной командой хуже сухой заметки, которая помогла восстановить сервис.
Где Sepia использовать не буду
Не каждый текст нужно «очеловечивать». Конфигурация nginx, вывод Nmap, журнал systemd и фрагмент API-ответа должны сохраняться дословно. Не нужно специально добавлять ошибки, разговорные слова или ломаную пунктуацию: такая маскировка сама быстро становится шаблоном.
Я также не хочу применять все рекомендации одновременно. Авторы Sepia прямо предупреждают: если механически инвертировать каждый признак AI-текста, получится новый узнаваемый отпечаток. Для конкретной статьи достаточно исправить то, что в ней действительно сломано.
Мой критерий простой. После редактуры текст должен звучать так, как я рассказал бы эту историю человеку рядом с серверной стойкой: где начал, во что упёрся, что проверил и почему оставил именно это решение.
Если Sepia поможет делать это стабильнее — она останется в нашем публикационном pipeline. Сегодняшняя статья уже прошла через неё.